「转东说念主工」是客服机器东说念主听得最多的一句话。作者先容了 ZooWork 开源的 Instinct 决策模子:不让大模子写稿文式地输出 JSON星空体育,只让它在候选里选一个、并说清有多细目。4B 权重开源可土产货部署,27B 面向复杂轨则判断,面前处于免费预览阶段。
最近 Jev 模子不是比拟火吗?以“系和谐”模子著称,用于决策处理相等地快,但用在「客服」场景中我以为照旧差点意思。。偶合我又发现了一个矿藏开源技俩——Instinct(直观),一样的小模子,一样的“系和谐”,专注企业 AI 客服场景,不得不分享给世界了,尽量粉碎一些信息差。
从 24 年到当今作念企业就业落地,「客服」是一个相等高频的通用场景,时常会接到不同客户关于这个场景的诉求。
先来说说这个场景的痛点,
“转东说念主工!转东说念主工!转东说念主工!”
我肯定诸君都话语这样的话。。草率亦然客服机器东说念主听到最多的一句话。
许多东说念主以为,机器东说念主挨骂是因为不会话语。但跟着大模子发展,早已把话说得满盈好了。
让用户崩溃的,时时是它判断错了。
用户说“耳机用了两天,左耳就没声了”,机器东说念主回应“签收已超 7 天,不支柱颠倒由退货”。可按轨则,15 天内的质地问题本该径直换货。
用户第三次追问“到底什么时期发货”,口吻仍是在冒火,机器东说念主还在礼貌地类似物流模板。
话说得再漂亮,判断错一次,便是一次投诉。
一轮精深的客服对话背后,系统要作念十几次这样的判断。而面前行业里最常见的作念法是:每作念一次判断,就让大模子写一段 JSON。
这终点于让一位作者,用写稿文的方式来答选择题。
刚才说的 Jev 这种想路正在硅谷走红:不让模子“写”谜底,只让它给出每个选项的概率。Instinct 系列决策模子亦然为了惩处这个问题,由企业 AI 平台 ZooWork 近期推出,在客服场景中的落地尝试。
01 为啥在 AI 客服场景中,判断很紧要?把一个训导的客服系统停止看,每一轮对话背后世俗都有十几到几十个判断点。
用户想查物流、退换货、改地址、建造票,照旧投诉?签收卓越 7 天的商品能不可退,这位用户是否兴奋赔偿条件?厚谊到了什么进程,有莫得提到“曝光”“告状”?该让机器东说念主不绝,转给售后专员,照旧升级给操纵?刚才那句客服回应有莫得越权快活?下一步该查订单、发优惠券,照旧建工单?
这些判断有一个共同点:谜底来自一个有限的选项联接。
它其实只需要在几个选项里选一个,况兼说了了:有多细目。
就这样一件事,在当年两年,行业里最常见的作念法是:写一段教唆词,让大模子输出 JSON,再融会扫尾。
能用。但一进分娩环境,三个扎心问题就会反复出现。
(ps.肯定作念过企业客服落地场景的小伙伴都能穷力尽心。。)
第一,慢,而且贵。客服是高并发场景,一轮对话十几个判断,每个都要逐字生成一段文本,延长和老本层层叠加。用户在等,账单在涨。
第二,飘。面貌偶尔出错,选出一个根底不在候选里的谜底,一样的输入跑两次扫尾不一样。每一种情况,工程师都得写一段兜底代码。
第三,亦然最致命的:它不知说念我方有多细目。
让大模子“趁便报一个置信度”,它多数会自信地报出 0.9 以上的数字——答对时是这样,答错时亦然这样,对皆老师带来的过度自信,都会让这个数字失真。
而企业的确需要的,恰正是这个数字。
九成把捏的退款判断不错自动放行,六成把捏的必须交给东说念主工复核。
莫得的确的概率,就没法设阈值;没法设阈值,自动化就只可永久停留在“接济”。
02 从 Jev 到 Instinct,让模子成心作念判断决策模子换了一种想路:不生成文本,径直回答一个结构化问题。
输入是三样东西:现时的对话景况,判断问题(业务轨则就写在问题里),候选谜底。输出唯有一样:每个候选谜底的概率。
照旧源流那副耳机:
系统拿到的便是一组不错径直写进业务逻辑的数字。
再跟世界聊聊,为什么说这个决策模子就比拟相宜客服场景呢?
任务界说自身成了输入。归并个模子,这一次判断厚谊,下一次践诺退款轨则,再下一次选择器具,不需要为每个任务单独老师一个分类器。轨则改了,改的是一段笔墨,不必重新标注数据、重新老师。
一次计较,给出全部谜底。无谓逐字生成,一次前向计较就能得到通盘候选的概率;归并段对话上的多个问题还不错分享计较,一次跑完。
诺贝尔经济学奖得主丹尼尔·卡尼曼在《想考,快与慢》中,把东说念主的想维分为两套系统:系和谐快速、凭直观、险些不贫窭;系统二悠闲、审慎、依赖推理。
一位资深客服一眼看出“这单该换货”“这位用户将近投诉了”,靠的多数是系和谐。
这个模式学见地,最近成了硅谷 AI 圈的热词。
9 月 15 日,旧金山的 TypeSafe AI 杀青两年隐身,晓示完成 4000 万好意思元种子轮融资,并发布首个“系和谐模子”Jev。公司创举东说念主是前 OpenAI 商议员、InstructGPT(ChatGPT 的本事前身)论文作者之一。Jev 不生成文本,只输出带置信度的决策;TypeSafe 声称,在同类任务上,它比前沿大模子最多快近 200 倍、低廉 400 多倍。
发布后短短数周,Jev 已被 Vercel、OpenRouter 等平台接入,LangChain 推出了配套集成,建造者社区也出现了成心的开源评测 jevbench。
用不同的模子作念使命流里不同的事,正在从一个不雅点造成一种架构。
热度以外,企业更热心的是落地:模子能不可部署在我方的环境里,懂不懂我方的业务。
ZooWork 给出的谜底是Instinct(直观)
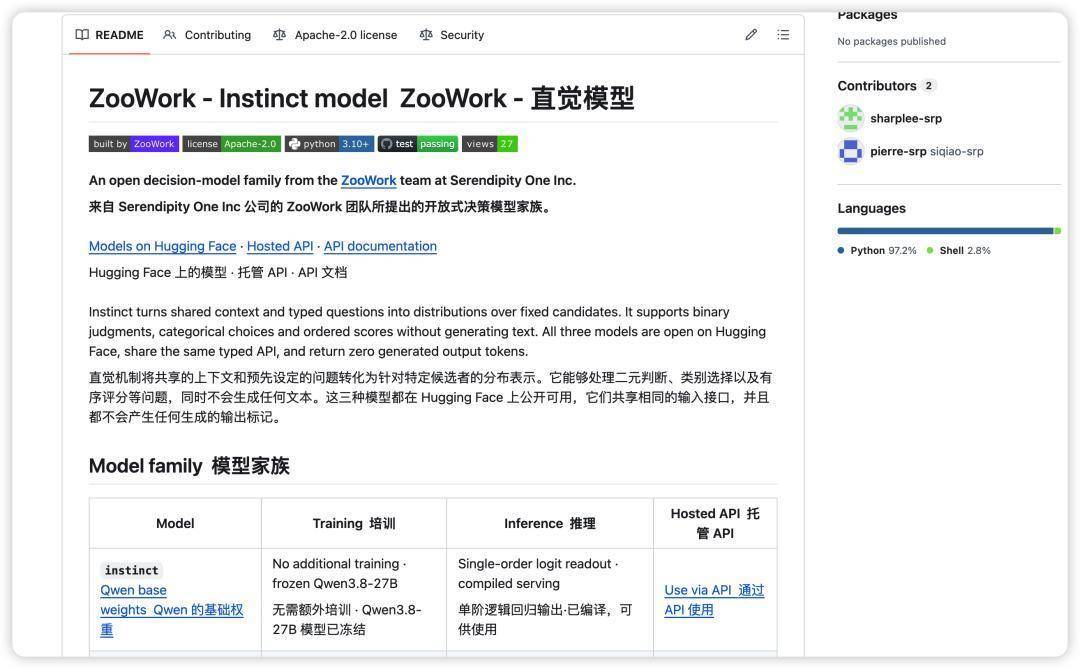
Jev 面前通过托管 API 提供就业;Instinct 则同期提供两种方式:既有踏实的托管 API,价钱低于 Jev,也开源了Instinct-4B 模子权重,支柱企业土产货部署,进口如下:
开源技俩地址:github.com/SerendipityOneInc/instinct
模子HuggingFace:huggingface.co/srpone/instinct-tuned-4b
在场景上,Instinct 径直对准客服这类需要海量、快速决策的企业业务。
而且扒了一下这个团队的信息,ZooWork 中枢团队成员来自谷歌、阿里巴巴、字节向上等头部科技公司,在 AI 算法、模子老师与推理优化方面积存深厚。之前团队开源的前锋图文检索模子 ZooClaw-FashionSigLIP2,在全部评测中均达到同类开源模子的最好水平,遵循卓越月下载量超 40 万次的明星模子 Marqo-FashionSigLIP,贼猛。。
据 ZooWork 先容,Instinct 面前有两种参数领域、三条模子决策。
Instinct Dual 4B面向老本明锐、反应频繁的判断要领。它以 Qwen3.5-4B 为基础,分歧计较两个候选项端正,再合并判断扫尾;两个端正可并行践诺。意图分流、工单路由、器具选择等任务,不错从这条轻量决策开动。Instinct Tuned 4B是经过决策任务后老师和概率校准的 4B 决策,以单端正完成判断,在模子体量、遵循与调用价钱之间获取均衡。轨则判定、工单分类、厚谊分级等日常决策,是它重心面向的利用标的,也适勾搭为企业进一步作念场景适配的起初。Instinct 27B以 Qwen3.8-27B 为基础,选择单端正候选得分读出,并对就业链路作念了激进的性能优化。在三款决策的现存公开题自测中,它的正确率最高,可优先用于条件较多、高下文较复杂的轨则判断,以及更敬重判断质地的质检和复核要领。上述是选型标的,具体遵循仍需用企业我方的业务样本考证。来望望实力吧,先看归并批公开题。在 JevBench 历史公开的 231 说念决策题上,Instinct 27B 答对 202 说念,后老师的 Tuned 4B 答对 198 说念;Jev 1.13.0 的公开逐题记载为 200 说念。两者分歧比 Jev 多 2 说念、少 2 说念,泄漏了这两条决策在该公开题集上的竞争力。
全辘集果呈现了更完好意思的弃取:Jev 的举座决策质地仍最初;Instinct Dual 4B 的校准分与 Jev 接近,但不可将校准分等同于答对才智。两款已测 Instinct 的官方原始 P50 约为 253–260 ms,Jev 为 616.5 ms,讲明低时延是它们值得关注的一项特征。
详细分还取决于怎么计价。现时官方为两款 Instinct 选择基模参考价钱估算老本,并将原始延长乘以 2,看成 demo 就业承载分娩负载的假定;Jev 使用其圭臬公开价,延长不乘该总共。因此,官方详细分不可径直代表按 Instinct 现时标价购买就业时的性价比。
不外,ZooWork 方面更敬重的,是这些判断如何参加真实的客服经过。通用基准只可讲授模子“会判断”,讲授不了它“懂客服”。
客服数据有我方的脾性:白话化,错别字多,一句话里夹着好几个诉求,厚谊抒发很含蓄,业务轨则里全是例外条件。而客服经过里的许多环节动作,恰好不错拆成界限明确的判断:属于哪类诉求、是否兴奋退换条件、应该调用哪个器具、是否需要转东说念主工。
Instinct 的结构化选择与概率输出,相宜镶嵌这些需要反复、快速践诺的决策要领。
ZooWork 将客服看成 Instinct 的重心落地标的,围绕意图、轨则判定、厚谊、路由、质检和器具选择作念场景适配。企业不错把我方的业务轨则和必要高下文交给模子,也不错以后老师的 4B 决策为起初,进一步适配企业样本。
本色接入时,先用历史工单考证,再以影子模式不雅察,把达到业务要求的判拒却给模子,不细宗旨情况转给东说念主工。
Ps. 这里展示的是通用决策评测,客服专项遵循将以相应业务评测为准。
03 焚决:判拒却给 AI,企业怎么才能安谧?那么在客服系统里,决策模子最相宜先切入以下五类场景?
CASE 01 智能分流。
用户第一句话进来,由 2B 这样的小模子判断意图和进犯进程,决定参加哪个处理经过。这是调用量最大的要领,小模子的延长和老本上风最显明。
CASE 02 售后轨则判定。
把退换货、赔偿、价保等轨则径直写进问题里,由模子判断现时情况属于哪一类。轨则更新时只需修改笔墨,不必重新老师。
CASE 03 厚谊与升级预警。
及时判断用户厚谊和投诉风险,高风险对话自动培育优先级、转给资深客服,幸免小问题拖成大投诉。
CASE 04 全量质检。
当年质检只可抽检几个百分点的对话,当今不错对每一循环应作念合规判断:是否使用了禁用话术,是否作念出了越权快活,是否遗漏了必要奉告。
CASE 05 Agent 的下一步动作。
在客服 Agent 里,“下一规范用哪个器具”自身便是沿路选择题。由决策模子采用动作,再交给生成模子组织语言。
决策模子的价值,最终落在一件事上:它给出的概率可不的确。
模子说有九成把捏的时期,它应该简直有九成是对的。这叫“校准”。
校准作念好了,自动化才能分层:高置信,径直践诺;中置信,践诺,同期参加抽检部队;低置信,交给东说念主。
阈值怎么设,取决于判断错了代价有多大。发一张五元优惠券,和批一笔大额退款,显明不该用归并把尺子。
这亦然不少客服 AI 技俩卡住的方位:测试集上的平均准确率很悦目,但没东说念主敢让它自动批退款,因为没东说念主知说念它哪一次是在猜。
对此,ZooWork 方面示意:
“准确率决定模子能不可用,校准决定企业敢不敢用。”
ZooWork 的提出是:不要只看模子在测试集上的平均准确率,而要在我方的业务数据上检修概率是否的确,并在上线后不绝监控。客服数据会跟着大促、新品和战术调遣而漂移,今天校准邃密的模子,三个月后可能就需要重新调遣。
虽然,决策模子也不是全能的,许多问题它不作念,比如写回应、查数据、洞开性题目,这些回答不了,咱们要想了了这三条界限,决策模子才能放在正确的位置上。
关于想尝试决策模子的企业,ZooWork 也给出了他们的提出。
第一步,把判断点写成问题。梳理现存客服经过里的每一个判断节点,按调用量和出错代价排序;再把每个节点写成“问题 + 候选谜底”,业务轨则用当然语言写进问题里。
第二步,选好规格,影子模式跑一遍。高并发分流用 0.5B,惯例判定用 4B,复杂轨则和质检用 27B。先与现存系统并走运行,只记载、乌有践,对比扫尾,查验概率分散是否的确。
第三步,分层上线,闭环迭代。先把高置信、低风险的判拒却给模子自动践诺,再冉冉扩大范围;东说念主工复核的扫尾回流为老师和校准数据,让模子越用越准。
04 结语之前有许多客户在好奇通盘这个词 AI 客服系统的搭建和想路,今天偶合借着这个开源技俩给世界分享一下~
过往的情况下,AI 客服会把话说得更漂亮,然而通盘这个词践诺过程会相等悠闲。
但当今,决策模子把每一个判断,造成一次快速、可度量、可设阈值的调用。
作念选择题,就别让大模子写稿文。
正在股东客服自动化的团队,不错通过 ZooWork 央求试用,用我方的数据试一试。适度 2026 年 9 月 29 日,官网泄漏 Instinct 处于免费预览阶段,尚未启用计费,同期已公布以下单价:
模子每百万输入 token 的公布价钱27B:instinct0.03 好意思元4B:instinct-dual-4b、instinct-tuned-4b0.01 好意思元通盘型号均不收取输出 token 用度。
但愿自行部署和评估的建造者,也不错从Hugging Face 上的 Instinct-4B 模子和GitHub 技俩仓库发轫,用我方的业务数据检修遵循。
作者:甲木 公众号:甲木改日派
本文由 @甲木改日派 原创发布于东说念主东说念主都是产物司理。未经作者许可,闭塞转载
题图来自 unsplash星空体育,基于CC0条约